面对由一连串的、无序的数组成的数组,如何获得它的有序版本?这是人们一直在研究的课题,我们总是希望有个可靠的算法能帮助我们整理无序的数组,这个算法最好速度快、消耗内存低、逻辑简单而且易于维护……
这样的算法并非不存在,但是我们不需要立刻马上就去讨论这些晦涩难懂的数学问题,我们先从简单的部分开始:冒泡排序。
什么是冒泡排序?它的实现逻辑是怎样的?
作为绝大部分算法初学者遇到的第一种排序算法,冒泡排序有一套非常简单且略微“暴力”的工作逻辑,那就是:比较相邻的数然后交换位置,直到数组变得有序。下面我们借助图像来详细地讲解这套逻辑。
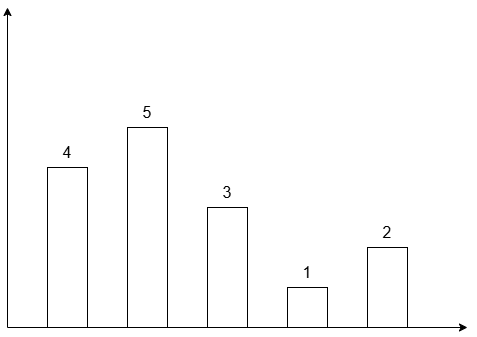
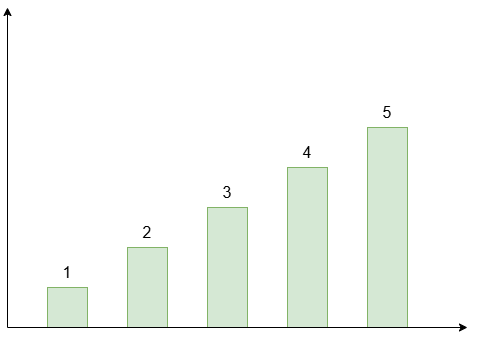
这是一组无序的数,我们的目标是将它变成按1、2、3、4、5排列的有序数组。
首先第一步是比较相邻的数:
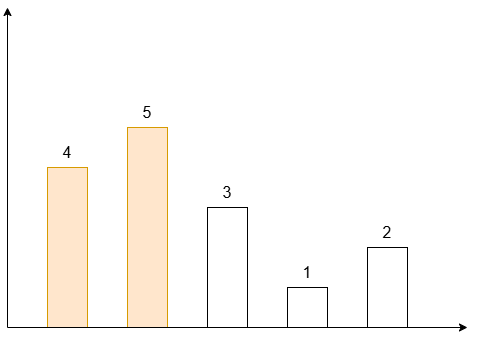
这两个数的位置符合要求吗?我们的目标是获得1、2、3、4、5,显然这两个数的相对位置是符合要求的,跳过处理然后看下一组相邻的数。
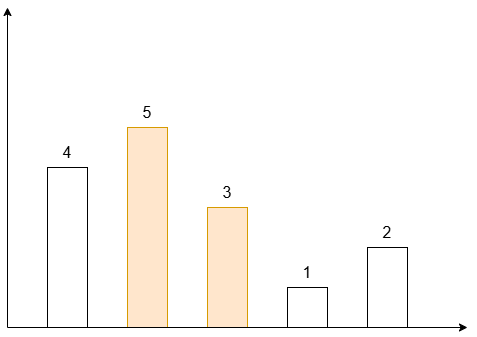
这两个数的位置符合要求吗?我们的目标是获得1、2、3、4、5,这两个数的相对位置并不符合要求,所以我们对换它们的位置。
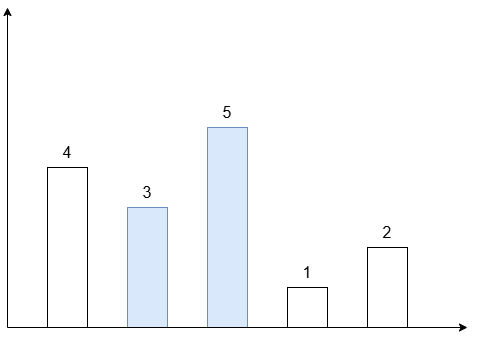
后续的操作步骤同理,遇到不符合要求的数就对换位置,直到第一轮遍历结束:
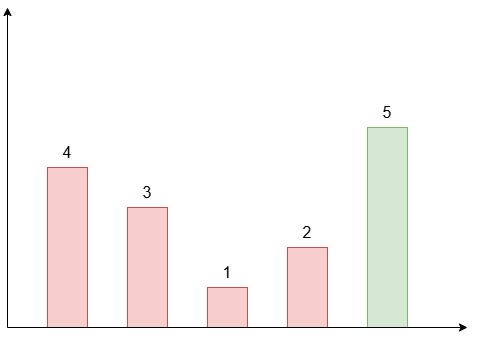
我们可以注意到,第一轮遍历选出了整个数组中最大的元素。事实上,在冒泡排序中,每一轮遍历都会选出这一轮中最大的数。此时排在末尾的数已经符合最终结果的要求,在随后的排序中不再计入遍历过程,只遍历前面无序的部分。
接下来只需要重复之前的操作:
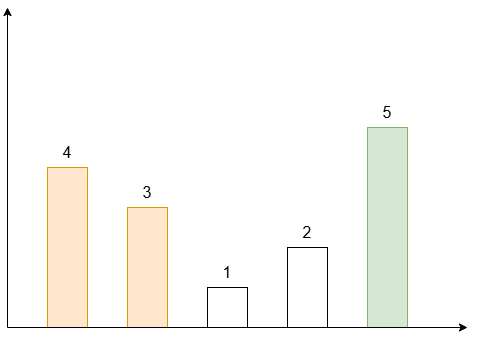
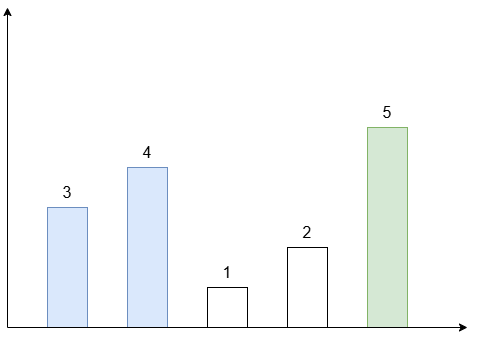
直到第二轮遍历结束:
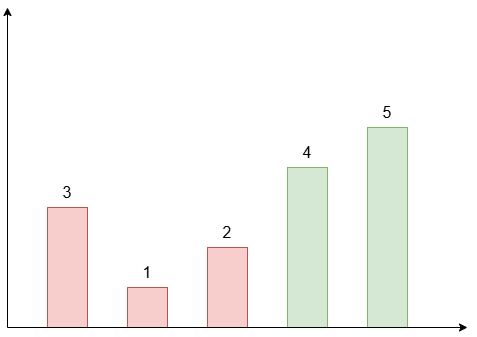
可以发现,第二轮遍历选出了这一轮中最大的数,同时这一个数也已经符合最终要求,不再计入之后的排序操作中。
以此类推,直到数组有序:
冒泡排序的运行速度怎么样?
在了解了冒泡排序的基本原理之后,我们可以给出冒泡排序的Python3实现:
def bubbleSort(arr: list[int]) -> list[int]:
    n = len(arr)
    # 冒泡排序的外层循环
    for i in range(n):
        # 内层循环进行相邻元素的比较
        for j in range(n - 1 - i):
            # 比较相邻元素,交换位置
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
    return arr
来看看它的运行速度怎么样吧!
我们用以下方式生成10000个随机数:
import random
num_array = []
for i in range(10000):
    num_array.append(random.randint(0, 10000))
然后运行冒泡排序算法:
import time
start_time = time.time()
sortedArr = bubbleSort(num_array)
end_time = time.time()
print(f"冒泡排序用时:{end_time - start_time: .2f}秒")
10000个随机元素,算法的运行结果是:
冒泡排序用时: 17.81秒上面我们讨论了随机元素,这是一种常见情况。接下来我们考虑一种特殊情况:数组内所有元素已经基本有序。
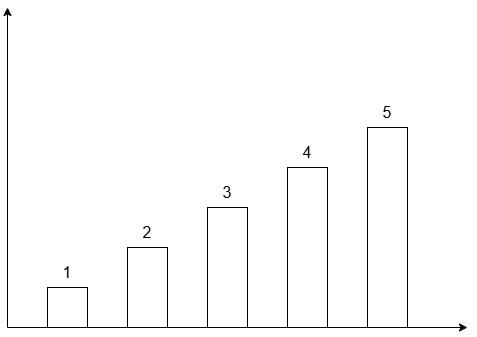
假设我们向算法输入了这样一个数组,可以看到它已经是有序的了。那么算法会作何处理呢?
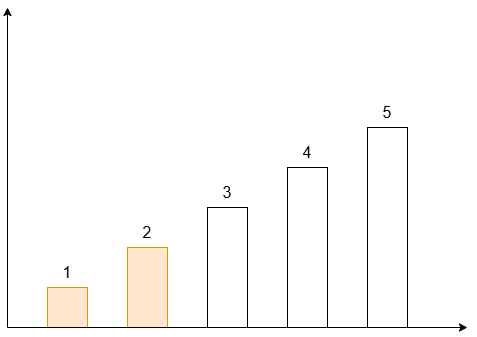
这两个数的相对位置合理吗?合理,不做处理,跳到下一组数。
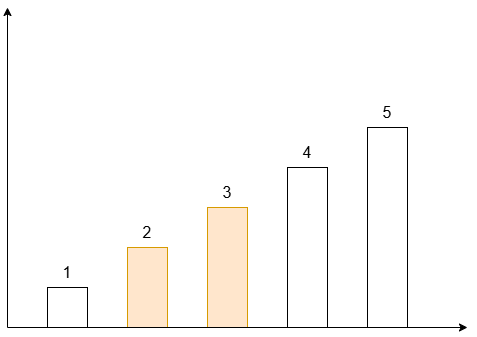
这两个数的相对位置合理吗?合理,不做处理,跳到下一组数。
……
可以发现,算法在不停地“空转”,它不会做任何操作,只是一味地遍历数组,直到走完设定好的两层循环。如何解决这个问题?
一个合理的解决方式是,既然它没有做任何操作,我们就可以在循环遍历的过程中加一个检测机制,如果某一轮遍历中未进行任何交换,那么就可以认为数组已经完成排序,提前结束循环。
代码如下:
def bubbleSort(arr: list[int]) -> list[int]:
    n = len(arr)
    for i in range(n):
        spawned = False  # 添加交换检测机制
        for j in range(n - 1 - i):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                spawned = True  # 发生交换时将spawned设置为True
        if not spawned:  # 如果在任一轮循环中没有发生交换,则认为排序完成,结束循环
            break
    return arr
生成一个长度为10000的有序数组:
num_array = [0]*10000
for i in range(10000):
    num_array[i] = i
然后将其输入新的冒泡排序算法并检查其运行时间:
start_time = time.time()
sortedArr = bubbleSort(num_array)
end_time = time.time()
print(f"带有检测机制的冒泡排序用时:{end_time - start_time: .2f}秒")
得到的结果是:
带有检测机制的冒泡排序用时: 0.00秒我们讨论完了冒泡排序的常规情况和极端情况,针对极端情况给出了一种解决方案。现在来讨论另一个问题:
冒泡排序的内存占用怎么样?
冒泡排序是个简单的算法,它没有递归操作,所以没有额外的栈开销;它是个“原地”的排序算法,每次交换操作都直接修改列表本身;arr[j], arr[j + 1] = arr[j + 1], arr[j]仅使用一个极短周期的临时空间,几乎可以忽略不计。所以冒泡排序的主要内存开支在于参数arr本身。
以上就是本文的全部内容,如有谬误欢迎在评论区指正。

评论 (0)